為什麼 TXT 的「ANSI」其實代表本機預設編碼?從 CP932 講清 Windows 的歷史包袱
Copyright Notice: This article is an original work licensed under the CC 4.0 BY-NC-ND license.
If you wish to repost this article, please include the original source link and this copyright notice.
Source link: https://v2know.com/article/1408
最近在處理日本舊系統的 TXT/CSV 時,我遇到了一個以前完全沒有注意過的問題:
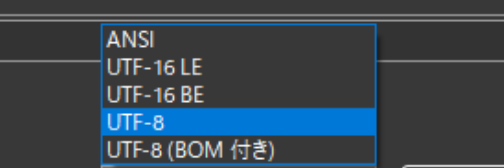
規格要求文字編碼使用 CP932,但我在文字編輯器的「另存新檔」裡,根本找不到 CP932。
能看到的通常只有:
- ANSI
- UTF-16 LE
- UTF-16 BE
- UTF-8
- UTF-8(BOM 付き)
那麼 CP932 到底在哪裡?
答案是:在典型的日文 Windows 環境中,畫面上的「ANSI」通常實際就是 CP932。
先講結論:ANSI 並不是一種固定的文字編碼
Windows 軟體中的「ANSI」,很多時候不是某一種固定編碼,而是指目前 Windows 使用的 ANSI Code Page,也就是本機預設的傳統非 Unicode 編碼。
例如在不同語言環境的 Windows 中,「ANSI」可能對應完全不同的編碼:
| Windows 語言/系統 Locale | 常見 ANSI Code Page | 常見名稱 |
|---|---|---|
| 日文 | CP932 | Windows-31J / MS932 |
| 簡體中文 | CP936 | GBK |
| 繁體中文 | CP950 | Big5 系列 |
| 西歐語系 | CP1252 | Windows-1252 |
所以:
ANSI ≠ 固定的一種編碼

ANSI
  ↓
Windows 的 ANSI Code Page
  ↓
依照目前系統 Locale 決定
  ↓
日文 Windows 通常為 CP932
但是 ANSI 明明是 American National Standards Institute?
沒錯。
ANSI 原本是:
American National Standards Institute
也就是「美國國家標準協會」。
所以第一次知道「ANSI 可以代表本機預設文字編碼」時,很容易產生疑問:
一個美國標準組織的名字,為什麼會突然變成 Windows 的文字編碼?
原因主要是 Windows 長期留下來的歷史命名。
Windows 所說的 ANSI Code Page 是什麼?
早期 Windows 尚未全面使用 Unicode。
不同國家與語言需要使用不同的單位元組或多位元組編碼,因此 Windows 會根據系統的語言環境指定一個預設 Code Page。
Windows 把其中一套稱為:
ANSI Code Page,簡稱 ACP。
很多舊式 Windows API、應用程式以及文字編輯器,都沿用了「ANSI」這個名稱。
久而久之,很多軟體的編碼選單就直接顯示:
ANSI
UTF-8
UTF-16
但這三個名字其實並不是完全同一個層級的概念。
UTF-8 是明確的文字編碼;CP932 也是明確的 Code Page。
而畫面中的 ANSI,更接近:
使用目前 Windows 的預設 ANSI Code Page
如果今天這台 Windows 的系統 Locale 是日文,那麼這個 Code Page 通常就是 CP932。
所以為什麼日本系統要求 CP932,我卻只能看到 ANSI?
這其實就是同一件事的兩種表示方式。
系統規格書可能會明確寫:
文字コード:CP932
或者:
文字コード:Shift_JIS
但某些 Windows 軟體在另存 TXT 時,只提供:
ANSI
在典型日文 Windows 環境下,它往往就是使用 CP932 保存。
注意:不能在任何電腦上都直接認為「ANSI = CP932」。ANSI 會受到 Windows 系統 Locale/預設 Code Page 的影響。
CP932 和 Shift_JIS 是完全一樣的嗎?
嚴格來說,不是完全一樣。
CP932 可以理解為 Microsoft 在 Shift_JIS 系列基礎上使用的 Windows 日文編碼,其中包含一些 Microsoft/NEC/IBM 擴充字元。
因此實務中經常會看到以下幾個名稱混用:
- Shift_JIS
- CP932
- Windows-31J
- MS932
在一般日本 Windows 業務系統中,它們經常被當作接近的概念處理,但在需要嚴格處理字元範圍時,仍然應該區分。
尤其是舊式 Access、VBA、CSV、固定長 TXT、批次處理等系統,最好確認規格真正要求的是:
Shift_JIS

還是

Windows-31J / CP932
Windows API 裡也能看到這段歷史
Windows API 長期存在很多名稱相同、但尾碼不同的函式,例如:
CreateFileA
CreateFileW
其中可以簡單理解為:
- A:使用傳統 Windows Code Page 的字串 API
- W:使用 Unicode Wide Character 的 API
這裡的 A 版本與 Windows 傳統的 ANSI/Code Page 世界有密切關係。
因此「ANSI」出現在 Windows 的文字處理中,本質上是幾十年前非 Unicode 時代留下來的歷史包袱。
為什麼這件事在日本舊系統中特別容易遇到?
如果主要使用現代 Web 系統,可能很少需要考慮 CP932,因為現在大部分系統已經統一使用 UTF-8。
但日本仍然存在大量較早建立的業務系統,例如:
- Access
- VBA
- 舊式 Excel 巨集
- CSV 匯入/匯出
- TXT 固定長資料
- Windows 批次程式
- 舊版基幹系統
這些系統經常是以 CP932 為前提建立的。
因此在把舊系統搬到 Power Platform、Web 系統、Azure 或其他以 Unicode/UTF-8 為主的環境時,文字編碼轉換很容易成為隱藏問題。
CP932 轉 UTF-8 時要注意什麼?
如果只是普通的平假名、片假名與常見漢字,通常不會有太大問題。
真正容易出問題的是一些特殊字元、機種依存文字以及編碼對應存在歷史差異的字元。
例如實務上需要特別留意:
- 丸數字,例如 ①、②
- 部分舊字體、異體字
- 髙、﨑 等字元
- 波浪線、全形符號等歷史上容易產生對應差異的字元
如果系統規格明確要求 CP932,不應該只是看到「日文能正常顯示」就直接認為 UTF-8 也可以。
對接舊系統時,文字內容相同,不代表檔案的 Byte 表現也相同。
TXT 本身其實沒有「固定編碼」
另外一個很重要的觀念是:
.txt 只代表這是一個純文字檔,並不代表它一定使用某一種文字編碼。
同樣一個:
sample.txt
內容可能使用:
- CP932
- UTF-8
- UTF-8 with BOM
- UTF-16 LE
- UTF-16 BE
副檔名本身無法告訴你真正的文字編碼。
所以當系統要求:
TXT
文字コード:CP932
真正要求的是「檔案內容的 Byte 必須按照 CP932 規則保存」,而不是只要副檔名是 .txt 就可以。
最後整理
這次最值得記住的其實就是以下幾點:
- ANSI 原本是 American National Standards Institute 的縮寫。
- Windows 軟體中的「ANSI」通常不是一種固定編碼。
- 它通常表示目前 Windows 使用的 ANSI Code Page(ACP)。
- 典型日文 Windows 環境中的 ACP 通常是 CP932。
- 因此日本 Windows 上「另存為 ANSI」很多情況下實際就是保存成 CP932。
- 但不能脫離系統環境,直接把 ANSI 永遠等同於 CP932。
- CP932 與 Shift_JIS 關係非常接近,但嚴格來說並不完全相同。
- 在舊式日本業務系統搬遷到 UTF-8/Unicode 系統時,編碼轉換值得專門確認。
以前看到「ANSI、UTF-8、UTF-16」並列在一起,很容易自然地認為 ANSI 也是某一種固定文字編碼。
真正理解 Windows 的歷史之後才會發現,這個 UI 名稱其實相當具有誤導性。
如果把「ANSI」直接理解成:
目前 Windows 的預設傳統非 Unicode Code Page
那麼 CP932、GBK、Big5,以及很多日本舊系統中看似奇怪的文字編碼設定,就會突然變得容易理解很多。
This article was last edited at